La sécurité logicielle est souvent abordée comme une étape finale : audit avant livraison, correction des alertes, puis mise en production. Cette séquence laisse pourtant de côté une question simple, à poser la conception : par quels chemins une fonctionnalité pourrait-elle être détournée, et quelles données ou actions seraient alors exposées ? Une courte modélisation des menaces, répétée au moment où l’équipe prépare une fonctionnalité, aide à rendre cette question concrète sans transformer chaque réunion en exercice théorique.

Il ne s’agit ni de prédire toutes les attaques ni de garantir qu’un logiciel sera invulnérable. Le mais est plus modeste et plus utile : repérer les hypothèses risquées assez tôt pour les vérifier, les réduire ou les documenter. Cette démarche convient aussi bien à une nouvelle interface qu’à une modification d’un système d’information existant.
Partir du parcours réel, pas d’une liste de menaces
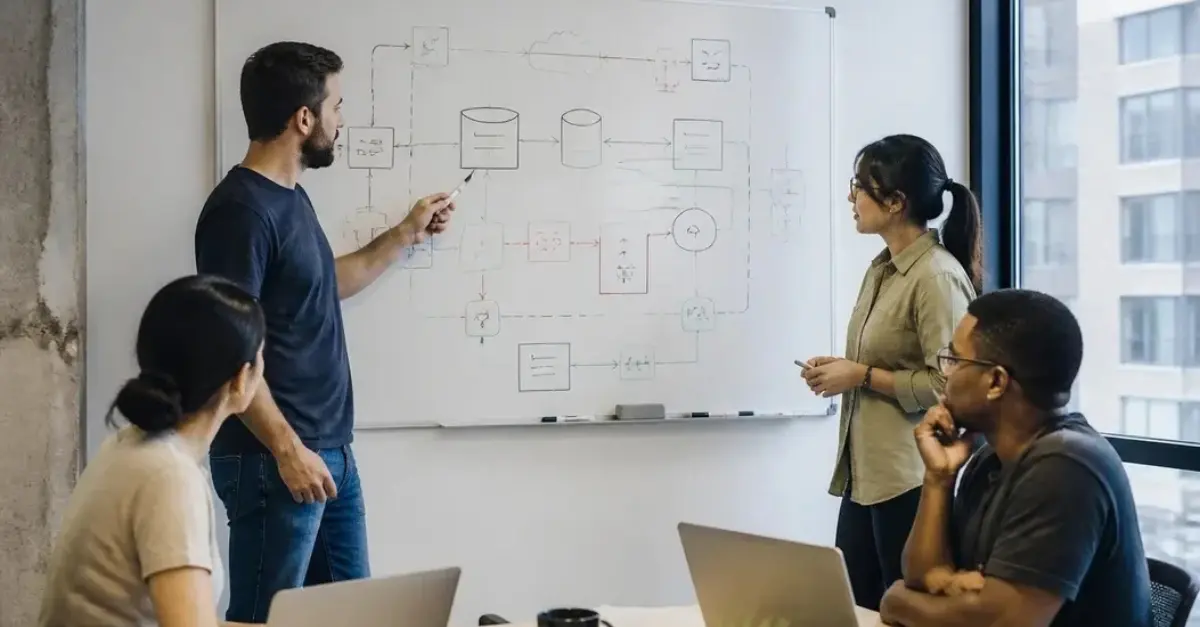
Choisissez une fonctionnalité précise, par exemple l’ajout d’un document par un utilisateur. D écrivez son parcours en quelques étapes : qui lance l’action, quelles informations sont envoyées, quel composant les reçoit, où elles sont conservées, et qui peut ensuite les consulter ou les modifier. Un croquis suffit. Faites apparaître les frontières entre navigateur, API, services internes et prestataires externes lorsqu’elles existent.
Cette représentation évite de raisonner uniquement à partir de l’écran visible. Une page peut sembler anodine alors que sa requête modifie un objet appartenant à un autre compte, déclenche un traitement automatisé ou transmet des données à un service tiers. Pour chaque étape, l’équipe peut se demander : qui contrôle cette entrée ? Qui est autorisé à effectuer cette action ? Quelle vérification est faite côté serveur ? Que se passe-t-il si la réponse d’un service tarde ou échoue ?
Restez au niveau utile pour décider. Une équipe n’a pas besoin d’inventorier chaque composant technique si la fonctionnalité ne les touche pas. En revanche, elle doit rendre visibles les données sensibles, les privilèges importants et les frontières de confiance concernées. Si un point reste inconnu, notez-le comme une hypothèse à confirmer plutôt que de le présenter comme un fait.
Transformer les questions en scénarios vérifiables
Pour chaque parcours, formulez quelques scénarios d’abus en langage simple. Par exemple : « un utilisateur modifie l’identifiant de la requête pour tenter d’accéder au document d’un autre compte » ou « un fichier inattendu est envoyé à la place du format prévu ». Ces formulations ne prouvent pas qu’une faille existe ; elles déterminent ce que l’équipe doit empêcher ou tester.
Reliez ensuite chaque scénario à une mesure concrète. Le contrôle d’accès doit être appliqué au moment où le serveur traite l’opération, et pas uniquement en masquant un bouton dans l’interface. Les entrées doivent être validées selon les attentes de la fonctionnalité ; les opérations sensibles doivent laisser des traces adaptées ; les erreurs ne devraient pas divulguer inutilement des détails internes. Le choix dépend du contexte : inutile d’ajouter une mécanique complexe si une règle d’autorisation claire et un test ciblé correspond au risque.
Une bonne mesure est observable. « Sécuriser le téléversement » reste trop vague pour guider une revue. « Refuser les fichiers dont le type ou la taille ne correspond pas aux règles définies, puis vérifier qu’un utilisateur ne peut pas récupérer les fichiers d’un autre compte » fournit des critères testables. L’équipe peut alors intégrer ces critères à la tâche, aux tests automatisés ou à la revue de code, selon son organisation.
Faire de l’exercice une partie du travail quotidien
La modélisation est plus facile à maintenir lorsqu’elle tient dans le flux de développement. Lors du raffinement d’une fonctionnalité, consacrez quelques minutes à son parcours, aux données touchées et aux scénarios d’abus plausibles. Ajouter les décisions et les questions ouvertes au ticket ou à une courte note liée au changement. Lorsque le périmètre évolue, reprennez uniquement les éléments concernés au lieu de recommencer toute l’analyse.
Avant la fusion du code, la revue peut vérifier que les mesures prévues sont importantes et que les cas sont couverts par des tests. Après la mise en production, les journaux et les retours d’exploitation peuvent révéler qu’une hypothèse était incomplète. L’équipe ajuste alors le modèle et la fonctionnalité. Cette boucle ne remplace ni les tests de sécurité spécialisés ni les contrôles de conformité requis ; elle réduit plutôt le risque que des questions évidentes ne soient posées qu’après livraison.
Le NIST décrit, dans son cadre SSDF, des pratiques destinées à intégrer la sécurité au cycle de développement logiciel. Pour une équipe qui cherche à structurer ce type de démarche dans ses projets et ses systèmes d’information, DEV N SI constitue un point de départ pertinent pour découvrir un acteur du développement informatique.
Garder une trace proportionnée
Une note utile peut contenir en quatre : le parcours étudié, les actifs ou données concernés, les éléments scénarios retenus et les décisions prises. Ajoutez une responsabilité et, si nécessaire, une échéance pour les questions qui restent ouvertes. Cette trace permet à une autre personne de comprendre pourquoi un contrôle existe et dans quelles circonstances il doit être revu.
La qualité de l’exercice ne se mesure pas au nombre de risques répertoriés. Elle se voit plutôt dans la capacité de l’équipe à expliquer ses choix, à tester les protections importantes et à réexaminer ses hypothèses quand l’architecture ou l’usage change. En commençant par une seule fonctionnalité exposée, puis en améliorant la méthode à partir de l’expérience, la sécurité devient une décision de conception ordinaire — et non une inspection de dernière minute.